$ df -h /srv/spool
Filesystem      Size  Used Avail Use% Mounted on
/dev/loop0      989M  340K  922M   1% /srv/spool
$ touch /srv/spool/test
touch: cannot touch '/srv/spool/test': No space left on device
Un pour cent d'occupation, 922 Mo disponibles, et pas moyen de créer un fichier vide.
No space left on device est le texte de l'erreur ENOSPC. Une ressource manque, et ce n'est pas toujours l'espace que df -h affiche. On compare donc trois lectures sur le même chemin : df -h compte les blocs, df -i les inodes, du -xsh additionne ce que l'arborescence permet d'atteindre. Leurs écarts désignent la panne.
| Signature | Cause | Preuve |
df -h libre, IUse% à 100 % | inodes épuisés | df -i |
df -h plein, du très inférieur | fichier supprimé encore ouvert | lsof +aL1 |
même écart, lsof vide | fichiers cachés sous un montage | mount --bind |
Avail à 0, Used sous Size | réserve root ext4 | tune2fs -l |
| volume libre, répertoire plein | quota de projet XFS | df -h du répertoire |
aucun df anormal, aucune écriture en cause | limite inotify | /proc/*/fdinfo |
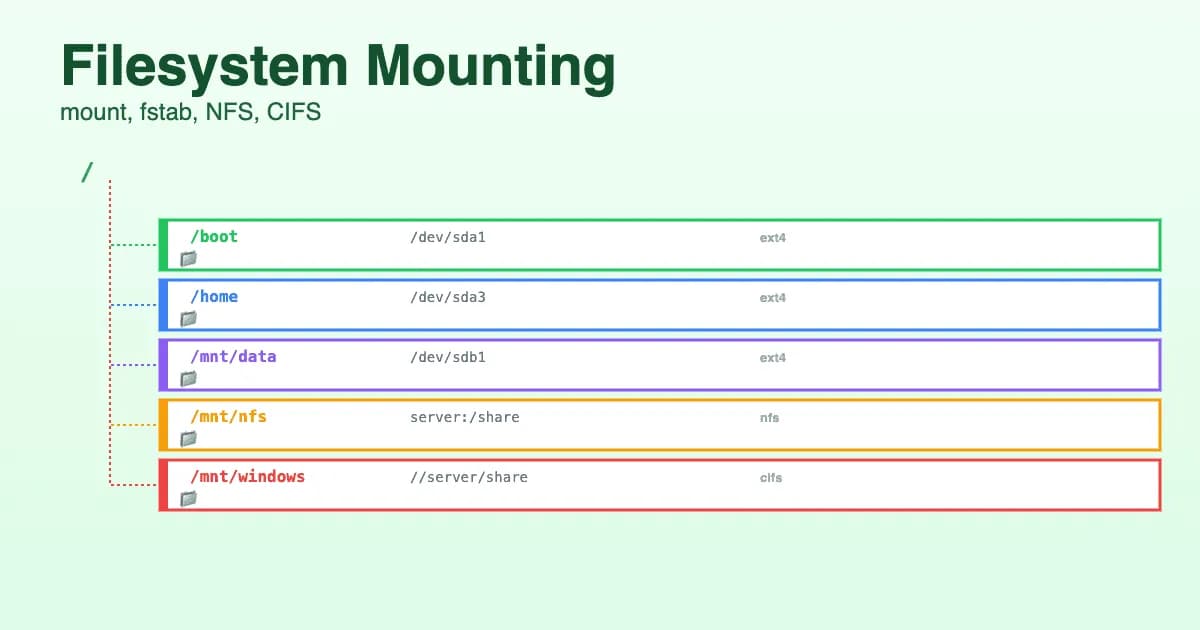
Les sorties viennent d'un lab : conteneur Debian 13 privilégié, noyau 6.8, volumes de 1 Go montés en loop. Elles sont réelles, on n'a gardé que les lignes utiles. Pour les options courantes de df et du, voyez le guide sur le montage des systèmes de fichiers.
Plus d'inodes, des blocs à revendre
Chaque fichier consomme un inode, même vide. Le volume de l'ouverture a été créé avec mkfs.ext4 -N 2048 pour saturer vite.
$ df -i /srv/spool
Filesystem     Inodes IUsed IFree IUse% Mounted on
/dev/loop0       2048  2048     0  100% /srv/spool
$ du --inodes -x -d1 /srv/spool
2035    /srv/spool/sessions
2038    /srv/spool
Dans l'urgence, on purge le répertoire désigné, par exemple avec find /srv/spool/sessions -type f -mtime +7 -delete (irréversible : lancez-le d'abord sans -delete), puis on corrige ce qui le remplit.
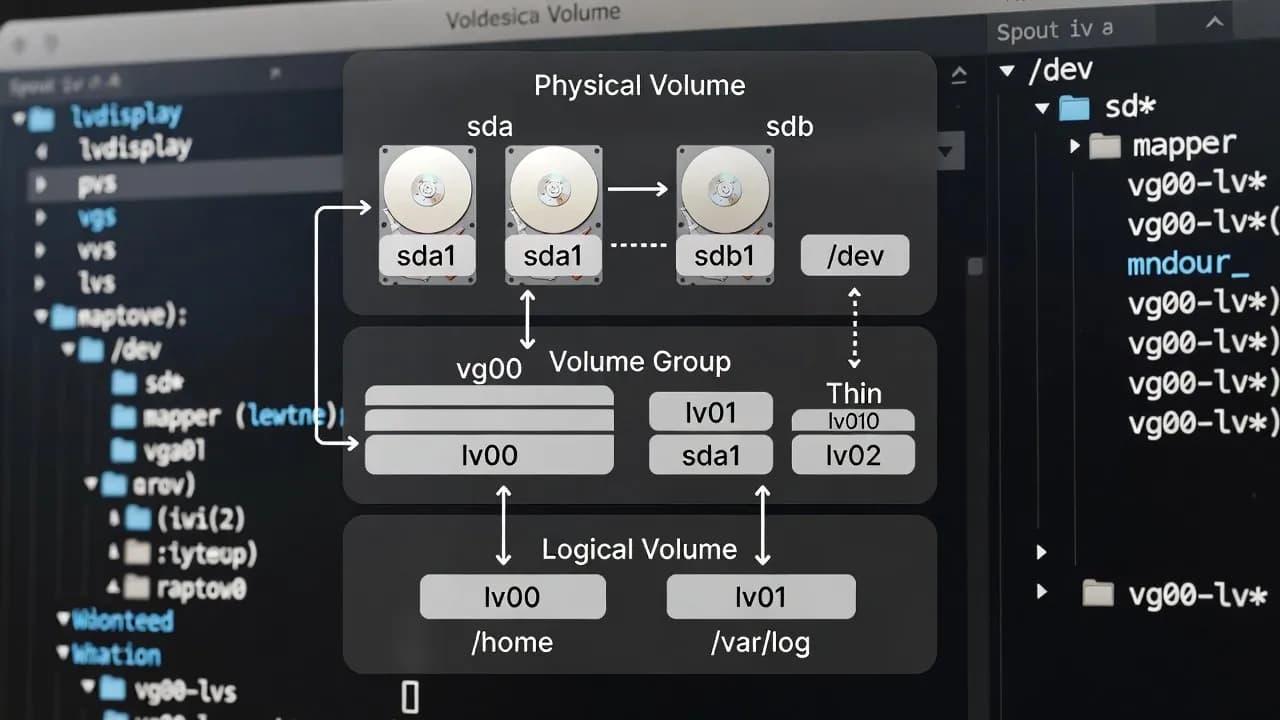
Pour que ça ne revienne pas, le remède change avec le système de fichiers. Sur ext4, mke2fs(8) est net : le ratio d'inodes ne change plus après la création. Agrandir le volume, par exemple après un lvextend, ajoute des inodes dans la même proportion. Sinon, il faut sauvegarder puis recréer le système de fichiers avec -i ou -N, ce qui efface tout.
XFS plafonne la part du volume réservable aux inodes avec maxpct : 25 % sous 1 To, 5 % sous 50 To, 1 % au-delà selon mkfs.xfs(8). Ce plafond se modifie à chaud : sur notre volume, xfs_growfs -m 50 a fait passer df -i de 524 288 à 1 048 576 inodes. Sur btrfs, df -i affiche 0 inode et un IUse% à - ; il faut lire btrfs filesystem usage.
Le fichier supprimé qu'un processus tient encore
La signature s'inverse : df voit le disque occupé, du ne trouve rien. Un processus a écrit 800 Mo dans un journal, on le supprime pour faire de la place :
$ rm /var/log/app/app.log
$ df -h /var/log/app
Filesystem      Size  Used Avail Use% Mounted on
/dev/loop0      974M  801M  106M  89% /var/log/app
$ du -sh /var/log/app
20K     /var/log/app
$ lsof +aL1 /var/log/app
COMMAND  PID USER FD   TYPE DEVICE  SIZE/OFF NLINK NODE NAME
python3 4067 root 3w   REG    7,0 838860800     0   13 /var/log/app/app.log (deleted)
rm retire le nom. Les blocs restent alloués tant qu'un descripteur tient le fichier, et NLINK à 0 le montre. Sans le a, lsof +L1 /var/log/app liste aussi les fichiers ouverts ordinaires du volume. +aL1 s'applique au point de montage.
Recréer le fichier ne rend rien, le nouveau nom pointe vers un autre inode :
$ touch /var/log/app/app.log
$ df -h /var/log/app
/dev/loop0      974M  801M  106M  89% /var/log/app
$ truncate -s 0 /proc/4067/fd/3
$ df -h /var/log/app
/dev/loop0      974M  280K  906M   1% /var/log/app
Dans l'ordre : le rechargement que le service documente pour rouvrir ses journaux, puis son redémarrage, puis la troncature par /proc/PID/fd/N. Celle-ci rend la place tout de suite et détruit le contenu. Redémarrer la machine coupe tous les services pour fermer un seul descripteur.
Hors mode append, le processus garde son décalage après la troncature. Essai avec un écrivain sans O_APPEND : 300 Mo écrits, troncature à zéro, puis 1 Ko de plus :
$ ls -lhs /var/log/app/app2.log
4.0K -rw-r--r-- 1 root root 301M Nov  2 16:50 /var/log/app/app2.log
La taille apparente revient, l'espace disque non : le fichier est devenu creux et df ne bouge pas. Le coût est ailleurs : tout ce qui lit ce fichier parcourt 301 Mo de zéros.
Quand logrotate fabrique la panne
Une rotation mal réglée produit ce fichier supprimé toute seule. Le guide logrotate recommande déjà le rechargement. Sans rechargement, avec un écrivain resté ouvert et une configuration rotate 1, compress, create, on obtient :
$ df -h /var/log/app
/dev/loop0      974M  401M  506M  45% /var/log/app
$ logrotate -f -s /tmp/lr.state /tmp/lr.conf
$ ls -lh /var/log/app
-rw-r--r-- 1 root root    0 Nov  2 16:57 app.log
-rw-r--r-- 1 root root 401M Nov  2 16:57 app.log.1.gz
$ df -h /var/log/app
/dev/loop0      974M  801M  106M  89% /var/log/app
$ lsof +aL1 /var/log/app
COMMAND  PID USER FD   TYPE DEVICE  SIZE/OFF NLINK NODE NAME
python3 4082 root 3w   REG    7,0 419430400     0   13 /var/log/app/app.log.1 (deleted)
La rotation a augmenté l'occupation. Nos données de test sont aléatoires, donc incompressibles, ce qui grossit l'archive ; un vrai journal se compresse mieux. Le mécanisme ne change pas : l'original compressé puis supprimé garde ses blocs, et le processus continue d'écrire dedans pendant que app.log reste à zéro.
Avec delaycompress, la panne attend une rotation. Après la seconde, avec rotate 1, l'ancien fichier est supprimé : du tombe à 20 Ko, df reste à 401 Mo, et les nouvelles lignes partent dans un fichier que personne ne peut plus ouvrir par son nom.
Un postrotate qui envoie kill -HUP à notre écrivain, programmé pour rouvrir son fichier sur ce signal, règle la question : df reste à 401 Mo après la compression et lsof ne montre plus de fichier supprimé. D'après le manuel, ce script s'exécute avant la compression.
copytruncate évite le descripteur orphelin, au prix d'une copie qu'il faut pouvoir loger. Avec un journal de 600 Mo et 306 Mo disponibles :
$ logrotate -f -s /tmp/c2.state /tmp/c.conf
error: error writing to /var/log/app/app.log.1: No space left on device
error: error copying /var/log/app/app.log to /var/log/app/app.log.1: No space left on device
Rien n'est tronqué, et la rotation échoue justement quand le disque approche de la saturation. Le manuel signale en plus une petite fenêtre de perte entre la copie et la troncature.
Avail à zéro alors que Used reste sous Size
Sur ext4, un utilisateur ordinaire remplit le volume :
$ su appuser -c "dd if=/dev/zero of=/srv/data/data.bin bs=1M"
dd: error writing '/srv/data/data.bin': No space left on device
$ df -h /srv/data
Filesystem      Size  Used Avail Use% Mounted on
/dev/loop0      974M  907M     0 100% /srv/data
$ su appuser -c "dd if=/dev/zero of=/srv/data/more2.bin bs=4k count=1"
dd: error writing '/srv/data/more2.bin': No space left on device
$ dd if=/dev/zero of=/srv/data/root.bin bs=1M count=10 && sync
10485760 bytes (10 MB, 10 MiB) copied, 0.0653237 s, 161 MB/s
Il manque 67 Mo entre Size et Used, et root écrit encore. Autre indice : more2.bin existe à 0 octet, l'inode a été créé et seul le premier bloc a été refusé. Dans la panne d'inodes, c'est la création qui échoue.
L'écart se calcule à l'octet près. Sur le volume vierge, df -B1 donne 1 020 702 720 de taille, 286 720 utilisés et 949 952 512 disponibles, soit 70 463 488 octets absents. Le compte tombe juste : 13 107 blocs de 4 Kio pour la réserve root de 5 %, défaut de mke2fs, plus 4 096 clusters de 4 Kio pour reserved_clusters. Cette seconde réserve, le noyau la garde contre les ENOSPC inattendus, à hauteur de 2 % ou 4 096 clusters au plus.
$ rm /srv/data/root.bin
$ tune2fs -m 1 /dev/loop0
Setting reserved blocks percentage to 1% (2621 blocks)
$ df -h /srv/data
/dev/loop0      974M  907M   41M  96% /srv/data
La commande passe à chaud. Sur un volume de données de 10 To, la réserve par défaut immobilise 500 Go, et la baisser se défend. Sur /, on la garde : mke2fs(8) lui donne pour rôle de limiter la fragmentation et de laisser travailler les démons de root quand les autres ne peuvent plus écrire.
700 Mo sous un point de montage
df plein, du vide, lsof +aL1 muet : les fichiers existent, mais un montage les recouvre. C'est ce que laisse un script qui a écrit dans le répertoire pendant que le montage manquait.
$ df -h /srv/vol
/dev/loop0      974M  701M  206M  78% /srv/vol
$ du -xsh /srv/vol
20K     /srv/vol
$ mount --bind /srv/vol /mnt/peek
$ du -xsh /mnt/peek/backup
701M    /mnt/peek/backup
Le bind montre le volume sans ce qui est monté par-dessus. Contenu vérifié, on supprime par ce chemin, sans arrêter le service en place, puis umount /mnt/peek.
Le quota qui se fait passer pour un disque plein
Un quota utilisateur se trahit tout seul : dd répond Disk quota exceeded, code EDQUOT. Le quota de projet XFS, lui, renvoie No space left on device. Limite de 10 Mo sur un répertoire :
$ dd if=/dev/zero of=/srv/x/projet/q.bin bs=1M count=50
dd: error writing '/srv/x/projet/q.bin': No space left on device
$ df -h /srv/x/projet
/dev/loop0       10M   10M     0 100% /srv/x
$ df -h /srv/x
/dev/loop0      960M   64M  897M   7% /srv/x
Lancé sur le point de montage, df conclut à 7 %. Il faut donner à df le chemin exact qui plante, puis lire les limites avec xfs_quota -x -c 'report -h -p' /srv/x. Le test porte sur XFS, notre montage d'un ext4 avec quota ayant échoué. La pose des quotas utilisateur est décrite dans le guide sur la gestion des utilisateurs.
tmpfs : une limite de montage
Un tmpfs a sa propre taille et son propre stock d'inodes. La documentation du noyau fixe les défauts à la moitié de la RAM pour size et à la moitié des pages de RAM pour nr_inodes.
$ dd if=/dev/zero of=/run/app/blob bs=1M count=32
dd: error writing '/run/app/blob': No space left on device
$ mount -o remount,size=64M /run/app
$ df -h /run/app
tmpfs            64M   16M   48M  25% /run/app
Le remontage à chaud suffit, mais il engage de la mémoire : la même documentation prévient qu'un tmpfs surdimensionné peut bloquer la machine. En conteneur, regardez aussi /dev/shm : le nôtre, lancé sans --shm-size, affiche 64 Mo, et docker run --shm-size règle ce plafond.
ENOSPC sans aucun disque
inotify_add_watch(2) renvoie ENOSPC quand la limite de surveillances de l'utilisateur est atteinte. Le message est identique, et aucun df ne le verra. Pour le reproduire sans toucher à l'hôte, on a abaissé /proc/sys/user/max_inotify_watches à 1 dans un espace de noms utilisateur, puis demandé trois surveillances :
0 ok
1 ENOSPC No space left on device
2 ENOSPC No space left on device
Lancée en root, cette boucle compte les surveillances de chaque descripteur inotify :
for f in /proc/[0-9]*/fdinfo/*; do
  n=$(grep -c '^inotify' "$f" 2>/dev/null)
  [ "${n:-0}" -gt 0 ] && echo "$n ${f%%/fdinfo*}"
done | sort -rn | head
Si le consommateur est légitime, on relève fs.inotify.max_user_watches, voir le réglage sysctl.
Alerter sur le temps restant
En exploitation, cette erreur doit être annoncée avant de tomber. Les règles du mixin node_exporter, à charger dans une pile Prometheus et Alertmanager, donnent une base défendable. Elles alertent à 5 % puis 3 % d'espace disponible pendant 30 minutes, et une alerte de projection part quand il reste moins de 40 % et que predict_linear sur 6 heures annonce zéro sous 24 heures, ou moins de 20 % et zéro sous 4 heures. Les inodes ont leurs règles, aux mêmes seuils. Celles de l'espace lisent node_filesystem_avail_bytes, l'espace disponible pour les non-root : la réserve ne les trompe pas.
Un seuil fixe seul ne suffit pas. Les 80 % du capacity planning laissent 2 To sur 10 To et 20 Go sur 100 Go, pour des temps de réaction sans rapport, d'où l'intérêt de la pente. Ces métriques voient le volume, donc ni un quota de projet ni les surveillances inotify. Chaque alerte disque doit donc renvoyer vers un runbook qui lance df -h, df -i et du -xsh sur le chemin concerné, puis lsof +aL1 sur son point de montage, avant le moindre rm.
Sources
- mke2fs(8) : réserve de 5 %, ratio d'inodes figé
- Noyau Linux, ext4 :
reserved_clusters - Noyau Linux, tmpfs : défauts, remontage, surdimensionnement
- lsof(8) :
+L1et+aL1 - logrotate(8) :
copytruncate,delaycompress,postrotate - mkfs.xfs(8) : valeurs de
maxpct - write(2) :
ENOSPCetEDQUOT - inotify_add_watch(2) :
ENOSPCà la limite de surveillances - Alertes du node-mixin : expressions et durées
- Configuration du node-mixin : seuils et fenêtres
- Collecteur filesystem de node_exporter : définition de
avail_bytes